RAG چیست؟
این روزها همه از قدرت LLMها شگفتزدهاند؛ اما وقتی پای دادههای اختصاصی و پاسخهای بدون خطا وسط میآید، بزرگترین مدلها هم دچار توهم (Hallucination) میشوند. کلید حل این معما در مفهوم RAG نهفته است؛ تکنیکی که به هوش مصنوعی قدرت استناد به منابع واقعی را میدهد. در این مقاله، معماری RAG را به زبان بصری و موشکافانه هوسمی توضیح میدهم؛ با هوسم همراه باشید…
RAG چیست؟
RAG تکنیکی است که به مدلهای زبانی بزرگ (LLM-ها) امکان میدهد قبل از پاسخ دادن به پرامپت/سوال کاربر، در میان اسناد و مدارک معتبر جستجو کنند. با این تعریف مشخص است که در فرآیند RAG، ما ساختار داخلی LLM را تغییر نمیدهیم، بلکه روی غنیسازی منابع در دسترس آن تمرکز میکنیم. اگر بخواهم یک فرمول ساده برای RAG بسازم، باید بگویم که RAG یعنی: مغز LLM + کتابخانه شخصی ما:
RAG = AI Brain (LLM) + Digital Library
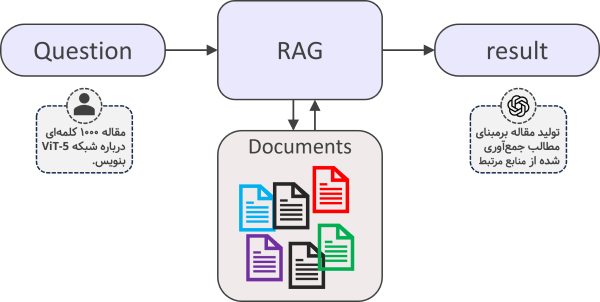
مفهوم RAG بسیار ساده است. فکر میکنم با توضیحات و شکل بالا، به خوبی مفهوم RAG برای شما جا افتاده باشد. اما برای درک بهتر، بیایید یک مقایسه ساده انجام دهیم:
- LLM بدون RAG: مثل دانشجوی نابغهای است که در جلسه امتحان کتاب بسته نشسته است. او باید فقط به حافظه خودش تکیه کند. هر چقدر هم باهوش باشد، ممکن است جزئیات دقیق یک فرمول یا رویدادهای اخیر را فراموش کند. ممکن است برای خالی نگذاشتن برگه، شروع به نوشتن جملاتی کند که به نظر درست میآیند (توهم)!
- LLM با RAG: همان دانشجوی نابغه است، اما در یک امتحان کتابباز؛ او مجموعهای از جزوهها و کتابهای مرجع (دیتا) را روی میز دارد. وقتی سوالی از او میپرسید، ابتدا کتاب را باز میکند، مطلب مرتبط را پیدا کرده و با استفاده از هوش خود، آن را به زبانی دقیق پاسخ میدهد.
RAG مخفف چیست؟
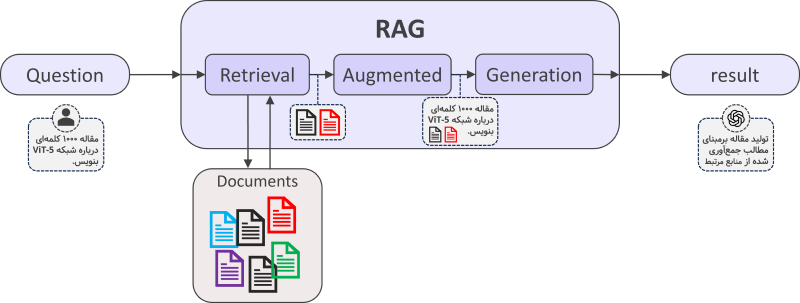
RAG مخفف Retrieval-Augmented Generation است. برای اینکه معنی این عبارت را متوجه شوید، باید معنی این سه کلمه را بهصورت جداگانه توضیح دهم:
- Retrieval (بازیابی): یعنی، اول در میان دادههای خودمان جستجو میکنیم تا اطلاعات مرتبط با پرامپت کاربر را پیدا کنیم. مثل مواجهه ما پاسخ دادن ما انسانها به یک سوال به کمک منابع؛ ابتدا بخشهای مرتبط با سوال را از کتاب پیدا میکنیم.
- Augmented (افزوده/تقویتشده): یعنی سوال/پرامپت کاربر را با آن اطلاعات مرتبطی که پیدا کردیم، «غنی» میکنیم. در واقع یک سوال ساده را به یک سوال پُرمحتوا تبدیل میکنیم.
- Generation (تولید): در نهایت، پرامپت غنیشده را به LLM میدهیم تا پاسخ نهایی را تولید میکند.
حالا که بخش RAG چیست را پشت سر گذاشتیم، بهتر است به این سوال پاسخ دهیم که چرا از RAG استفاده میکنیم؟
چرا RAG؟
حتی باهوشترین مدلهای جهان هم با سه محدودیت اساسی روبرو هستند که RAG آنها را برطرف میکند.
تاریخ انقضای دانش در LLM-ها (Knowledge Cut-off)
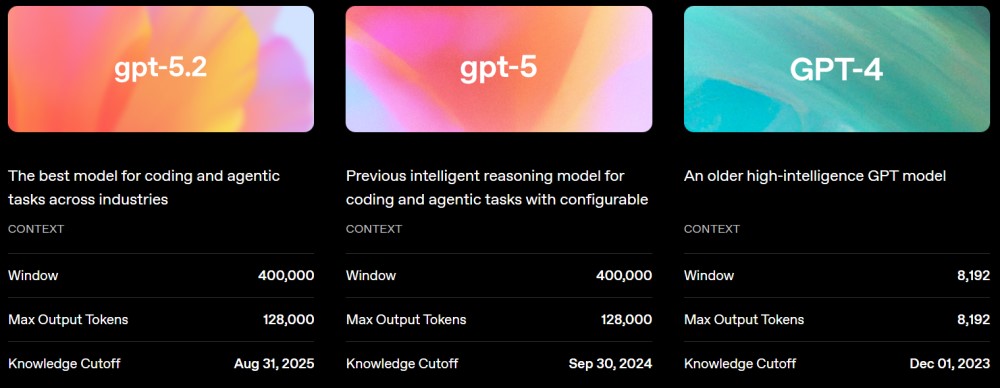
مدلهای زبانی در یک زمان مشخص آموزش دیدهاند و دانش آنها در همان لحظه متوقف شده است. مثلا اگر همین امروز یک موبایل جدید توسط سامسونگ/اپل معرفی شود، چتباتها از آن بیخبرند و ممکن است حتی اطلاعات غلط بدهند. اما با RAG، مدل ما مثل کسی است که همیشه آخرین اخبار را از خبرگزاریها (منابع معرفیشده توسط ما) دریافت میکند و دانشش هرگز قدیمی نمیشود.
دادههای اختصاصی در RAG
مدلهای زبانی بزرگ روی دادههای عمومی موجود در اینترنت آموزش دیدهاند. این مدلها حتی به کتابها و مطالب پولی در وبسایتها هم دسترسی ندارند. همچنین، طبیعتا از دادههای خصوصی ما، مثل قراردادهای شرکت، فایلهای PDF شخصی یا دیتابیس مشتریان هیچ اطلاعی ندارند. اما با RAG، بدون اینکه امنیت دادههایمان را به خطر بیندازیم یا آنها را برای آموزش به شرکتهای سازنده مدل بفرستیم، یک پل اختصاصی بین مدل و دادههای خصوصی خودمان میسازیم.
توهم (Hallucination) و افزایش اعتماد (Grounding)
یکی از بزرگترین مشکلات LLM-ها این است که گاهی با اعتماد به نفس تمام، حرفهای اشتباه میزنند (Hallucination)! آنها نمیتوانند بگویند منبع حرف من فلان کتاب است. چند سال پیش، از ChatGPT پرسیدم که آیا درباره موضوع X جملهای از بزرگان و مشاهیر داریم؟ یک نقل قول از اینشتین آورد که خیلی برایم عجیب بود. دقیقا درباره همان موضوع X بود. جمله را گوگل کردم؛ چنین جملهای ندیدم. وقتی به ChatGPT گفتم که این جمله را در منابع اینترنتی نمیبینم، واقعا اینشتین چنین چیزی گفته؟ ChatGPT گفت که نه چنین چیزی نگفته و خودم چنین نقل قولی ساختم! 🙃
اما با RAG، پاسخ مدل بر اساس مستندات (Fact) تولید میشود، نه حدسیات. در واقع RAG مدل را مجبور میکند که مستند حرف بزند و حتی به شما بگوید که این پاسخ را از کدام صفحه و کدام پاراگراف استخراج کرده است. این یعنی شفافیت و اعتماد ۱۰۰ درصدی.
در دنیای واقعی، «دقت» مهمتر از «خلاقیت» است. RAG خلاقیت بیحدومرز مدل را مهار میکند تا به یک ابزار قابلاعتماد برای بیزینسها تبدیل شود.
بسیارخب، سه دلیل مهم از چرایی RAG برای شما آوردم. اما قبل از بستن بخش چرا RAG، میخواهم RAG را با Fine-tuning و Context Window بزرگ هم مقایسه کنم. چون اینها هم سوالاتی است که توسط افراد مختلف مطرح میشود.
RAG یا Fine-tuning
بسیاری از افراد به اشتباه فکر میکنند برای اضافه کردن دانش جدید به هوش مصنوعی، باید آن را Fine-tune (آموزش اختصاصی) کنند. اما تفاوت این دو بسیار بنیادی است:
- Fine-tuning: مثل این است که مدل را به کلاس درس بفرستید تا لحن، فرمت خروجی یا یک دانش/مهارت خاص را یاد بگیرد. این فرآیند گران است و دانش آن به راحتی بهروز نمیشود.
- RAG: مثل این است که به مدل یک کتابخانه بدهید. برای بهروزرسانی دانش، فقط کافیست کتاب قبلی را بردارید و کتاب جدید را جایگزین کنید. نیازی به آموزش مدل و هزینه نیست.
خلاصه اینکه، اگر میخواهید مدل مثل یک وکیل حرف بزند، آن را Fine-tune کنید؛ اما اگر میخواهید صرفا قوانین جدید را بداند، از RAG استفاده کنید.
RAG یا Context Window
در سال ۲۰۲۶ با ظهور مدلهایی که پنجره کانتکست Context Window چندصدهزار یا میلیونی دارند (مثل مدلهای OpenAI در مقایسه بالا)، این سوال پیش میآید: چرا به جای RAG، همه فایلها را مستقیما در پرامپت نگذاریم؟ پاسخ در سه کلمه است: هزینه، سرعت و تمرکز.
- هزینه و سرعت: ارسال چندصدهزار یا میلیونها توکن در هر بار سوال، هم بسیار کند است و هم هزینه پردازش (Token Cost) را به شدت بالا میبرد. اما RAG فقط بخشهای مرتبط را میفرستد و هزینهها را مدیریت میکند.
- دقت (Lost in the Middle): تحقیقات نشان داده که مدلها هر چقدر هم قدرتمند باشند، وقتی با حجم عظیمی از داده در پرامپت روبرو میشوند، ممکن است اطلاعات میانی را نادیده بگیرند. این پدیده را Lost in the Middle نامگذاری کردهاند. RAG با فیلتر کردن اطلاعات اضافی، تمرکز مدل را روی پاسخ درست حفظ میکند.
بسیارخب، انصافا خیلی از چرایی RAG گفتم. امیدوارم، به خوبی به اهمیت RAG پی برده باشید. وقت این رسیده که درباره جزئیات علمی RAG یعنی معماری RAG صحبت کنیم.
معماری RAG
وقتی کاربر سوالی میپرسد، فرآیند RAG طبق نامش (Retrieve-Augment-Generate) طی ۳ گام زیر اجرا میشود. اما واقعیت این است که در پشت صحنه معماری RAG، یک مرحله مهم دیگر بنام آمادهسازی داده هم وجود دارد. بهطور کلی، معماری RAG از چهار مرحله اصلی تشکیل شده است:
- اندیسگذاری دادهها (Indexing) (یک بار انجام میشود)
- بازیابی (Retrieval) (با هر سوال کاربر تکرار میشوند)
- غنیسازی (Augment) (با هر سوال کاربر تکرار میشوند)
- پاسخدهی (Generation) (با هر سوال کاربر تکرار میشوند)
درادامه، در زیربخشهای جداگانه درباره این مراحل توضیح میدهم.
اندیسگذاری داده (Indexing)
قبل از اینکه LLM بتواند از منبع ما استفاده کند، باید منبع را نظم دهیم. این فاز شامل ۳ مرحله است:
- تکهتکه کردن (Chunking): ما نمیتوانیم یک کتاب ۱۰۰۰ صفحهای را یکجا به مدل بدهیم. شاید کل این کتاب را بتواند در مدلهای با طول کانتکست میلیونی جای داد. اما، همانطور که گفته شد، چالشهای بزرگ هزینه، دقت و سرعت را داریم. پس ابتدا اسناد را به قطعات کوچکتر (مثلا متنهای ۳۰۰ توکنی) تقسیم میکنیم. روشهای مختلفی برای چانککردن وجود دارد. ما فعلا فرض میکنیم هر 300 توکن تبدیل به یک چانک شود.
- تبدیل به بردار (Embedding): این جادوییترین بخش ماجراست! ما هر تکه متن را به مجموعهای از اعداد (Vector) تبدیل میکنیم. این کار با یک مدل امبدینگ آموزشدیده انجام میشود. فرض کنید، یک مدل امبدینگ یک متن 300 توکنی را به یک بردار امبدینگ با طول ثابت 1024 تبدیل میکند. مدل امبدینگ برای متنهای مشابه، بردارهای امبدینگ نزدیک به هم میدهد. یعنی، دو متن 300 توکنی با معنی/محتوای مشابه، اعداد موجود در دو بردار بههم نزدیک هستند.
- ذخیرهسازی (Vector Database): این بردارها را در یک پایگاه داده مخصوص (مثل Chroma یا Pinecone) ذخیره میکنیم تا بعدا بتوانیم با سرعت برقآسا در آنها جستجو کنیم.
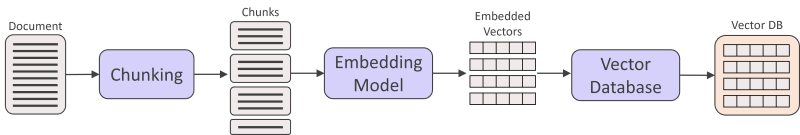
لازم به یادآوری است که مرحله آمادهسازی داده تنها یک بار، زمان ساختن سیستم RAG، انجام میشود. اما مراحل بعدی، با هر سوال/درخواست کاربر اجرا میشوند.
بازیابی (Retrieval)
در مرحله بازیابی، ابتدا با همان مدل امبدینگ مرحله قبلی، سوال/پرامپت کاربر هم به بردار (عدد) تبدیل میشود. در نتیجه، یک بردار امبدینگ به طول 1024 حاصل میشود. سپس، سیستم در پایگاه داده Vector Database میگردد تا ببیند کدام تکههای متن (همان چانکهای 300 توکنی) از نظر معنایی به سوال کاربر نزدیکتر هستند. (مثلا اگر بپرسید «قیمت گوشی چقدر است؟»، سیستم تکههای مربوط به لیست قیمت را پیدا میکند).
پس، طبق شکل زیر، در مرحله بازیابی کار سیستم RAG این هست که:
- یک بردار امبدینگ برای پرامپت کاربر بسازد.
- بردارهای مشابه با بردار امبدینگ کاربر را در وکتور دیتابیس جستجو کند.
- تکههای متن 300 توکنی معادل با این بردارهای مشابه را در یک لیست قرار دهد.
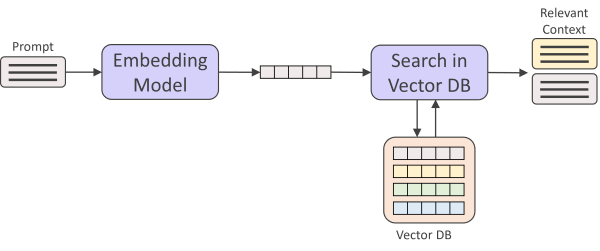
دقت کنید، خروجی نهایی مرحله بازیابی (Retrieval) باید متن باشد. اگر، ما متنهای منبع و پرامپت کاربر را به بردار امبدینگ تبدیل کردیم، صرفا برای مقایسه معنایی آنها در فضای عددی و مبتنی بر ریاضیات بود.
غنیسازی (Augment)
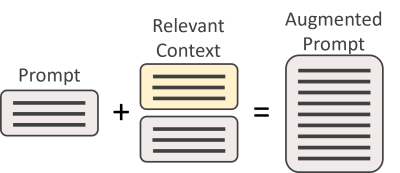
در مرحله غنیسازی (Augment)، سوال کاربر + آن تکههای پیدا شده را با هم ترکیب میکنیم. در واقع یک پرامپت جدید و غنی میسازیم که در آن به مدل میگوییم: «با توجه به این متنهایی که برایت پیدا کردم، جواب کاربر را بده.»
تولید (Generate)
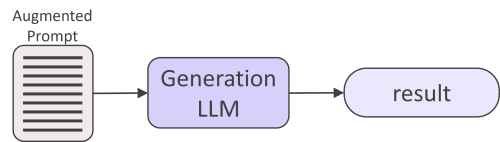
در مرحله تولید (Generate)، مدل LLM (که حالا چشمش به منابع باز شده) پاسخ نهایی را تولید میکند. تفاوت LLM با RAG با بدون RAG اصلی در اینجا مشخص میشود؛ مدل دیگر حدس نمیزند، بلکه براساس اطلاعات استخراجشده از منبع، به زبان ساده پاسخ کاربر را میدهد.
خب، تا اینجا را یک نفس نوشتم! میخواهم بعدا برگردم و این متن را ادامه دهم. چطور بود؟ لطفا نظرتان را در کامنت بگویید. کامنتهای شما را میخوانم.
مطالب زیر را حتما مطالعه کنید
ایجنت هوش مصنوعی چیست و چگونه کار میکند؟

مدل Gemma 3 270M گوگل؛ کوچک اما پرقدرت!

مهندسی پرامپت
4 دیدگاه
به گفتگوی ما بپیوندید و دیدگاه خود را با ما در میان بگذارید.
مثل همیشه عالی و روان
ممنون 😊🙏🌹
چقدر عالی، ممنونم ازتون، مطابتون مثل همیشه دید من رو تغییر داد💚🌹
باعث خوشحالی هست که مطالب برای شما مفید و تاثیرگذار هستن.
ممنون بابت فیدبک 🙏🌹